
談 Agent 的時候,充斥著「自主推理」「感知環境」「自我反思」這類詞彙。它們很生動,但對一個寫了十幾年程式的工程師來說,這些詞往往帶來的是模糊與不安 —— 因為它們沒有對應到任何已知的工程概念。
而不安通常不是因為技術太新,是因為詞彙沒有落地。
實際上,AI Agent 不是憑空出現的新物種。 它是物件導向、Actor Model、微服務與事件驅動架構在 LLM 時代的延伸 —— 換了一個控制流的來源,但底層的結構問題與解法幾乎沒變。
今天要做的就是這場翻譯。但這裡有一個必須先講清楚的原則:
對照的價值在於降低理解成本,不在於證明「這其實是舊東西」。 所以每一組對照,我都會同時寫出對不起來的地方 —— 那個差異往往才是真正需要注意的部分。
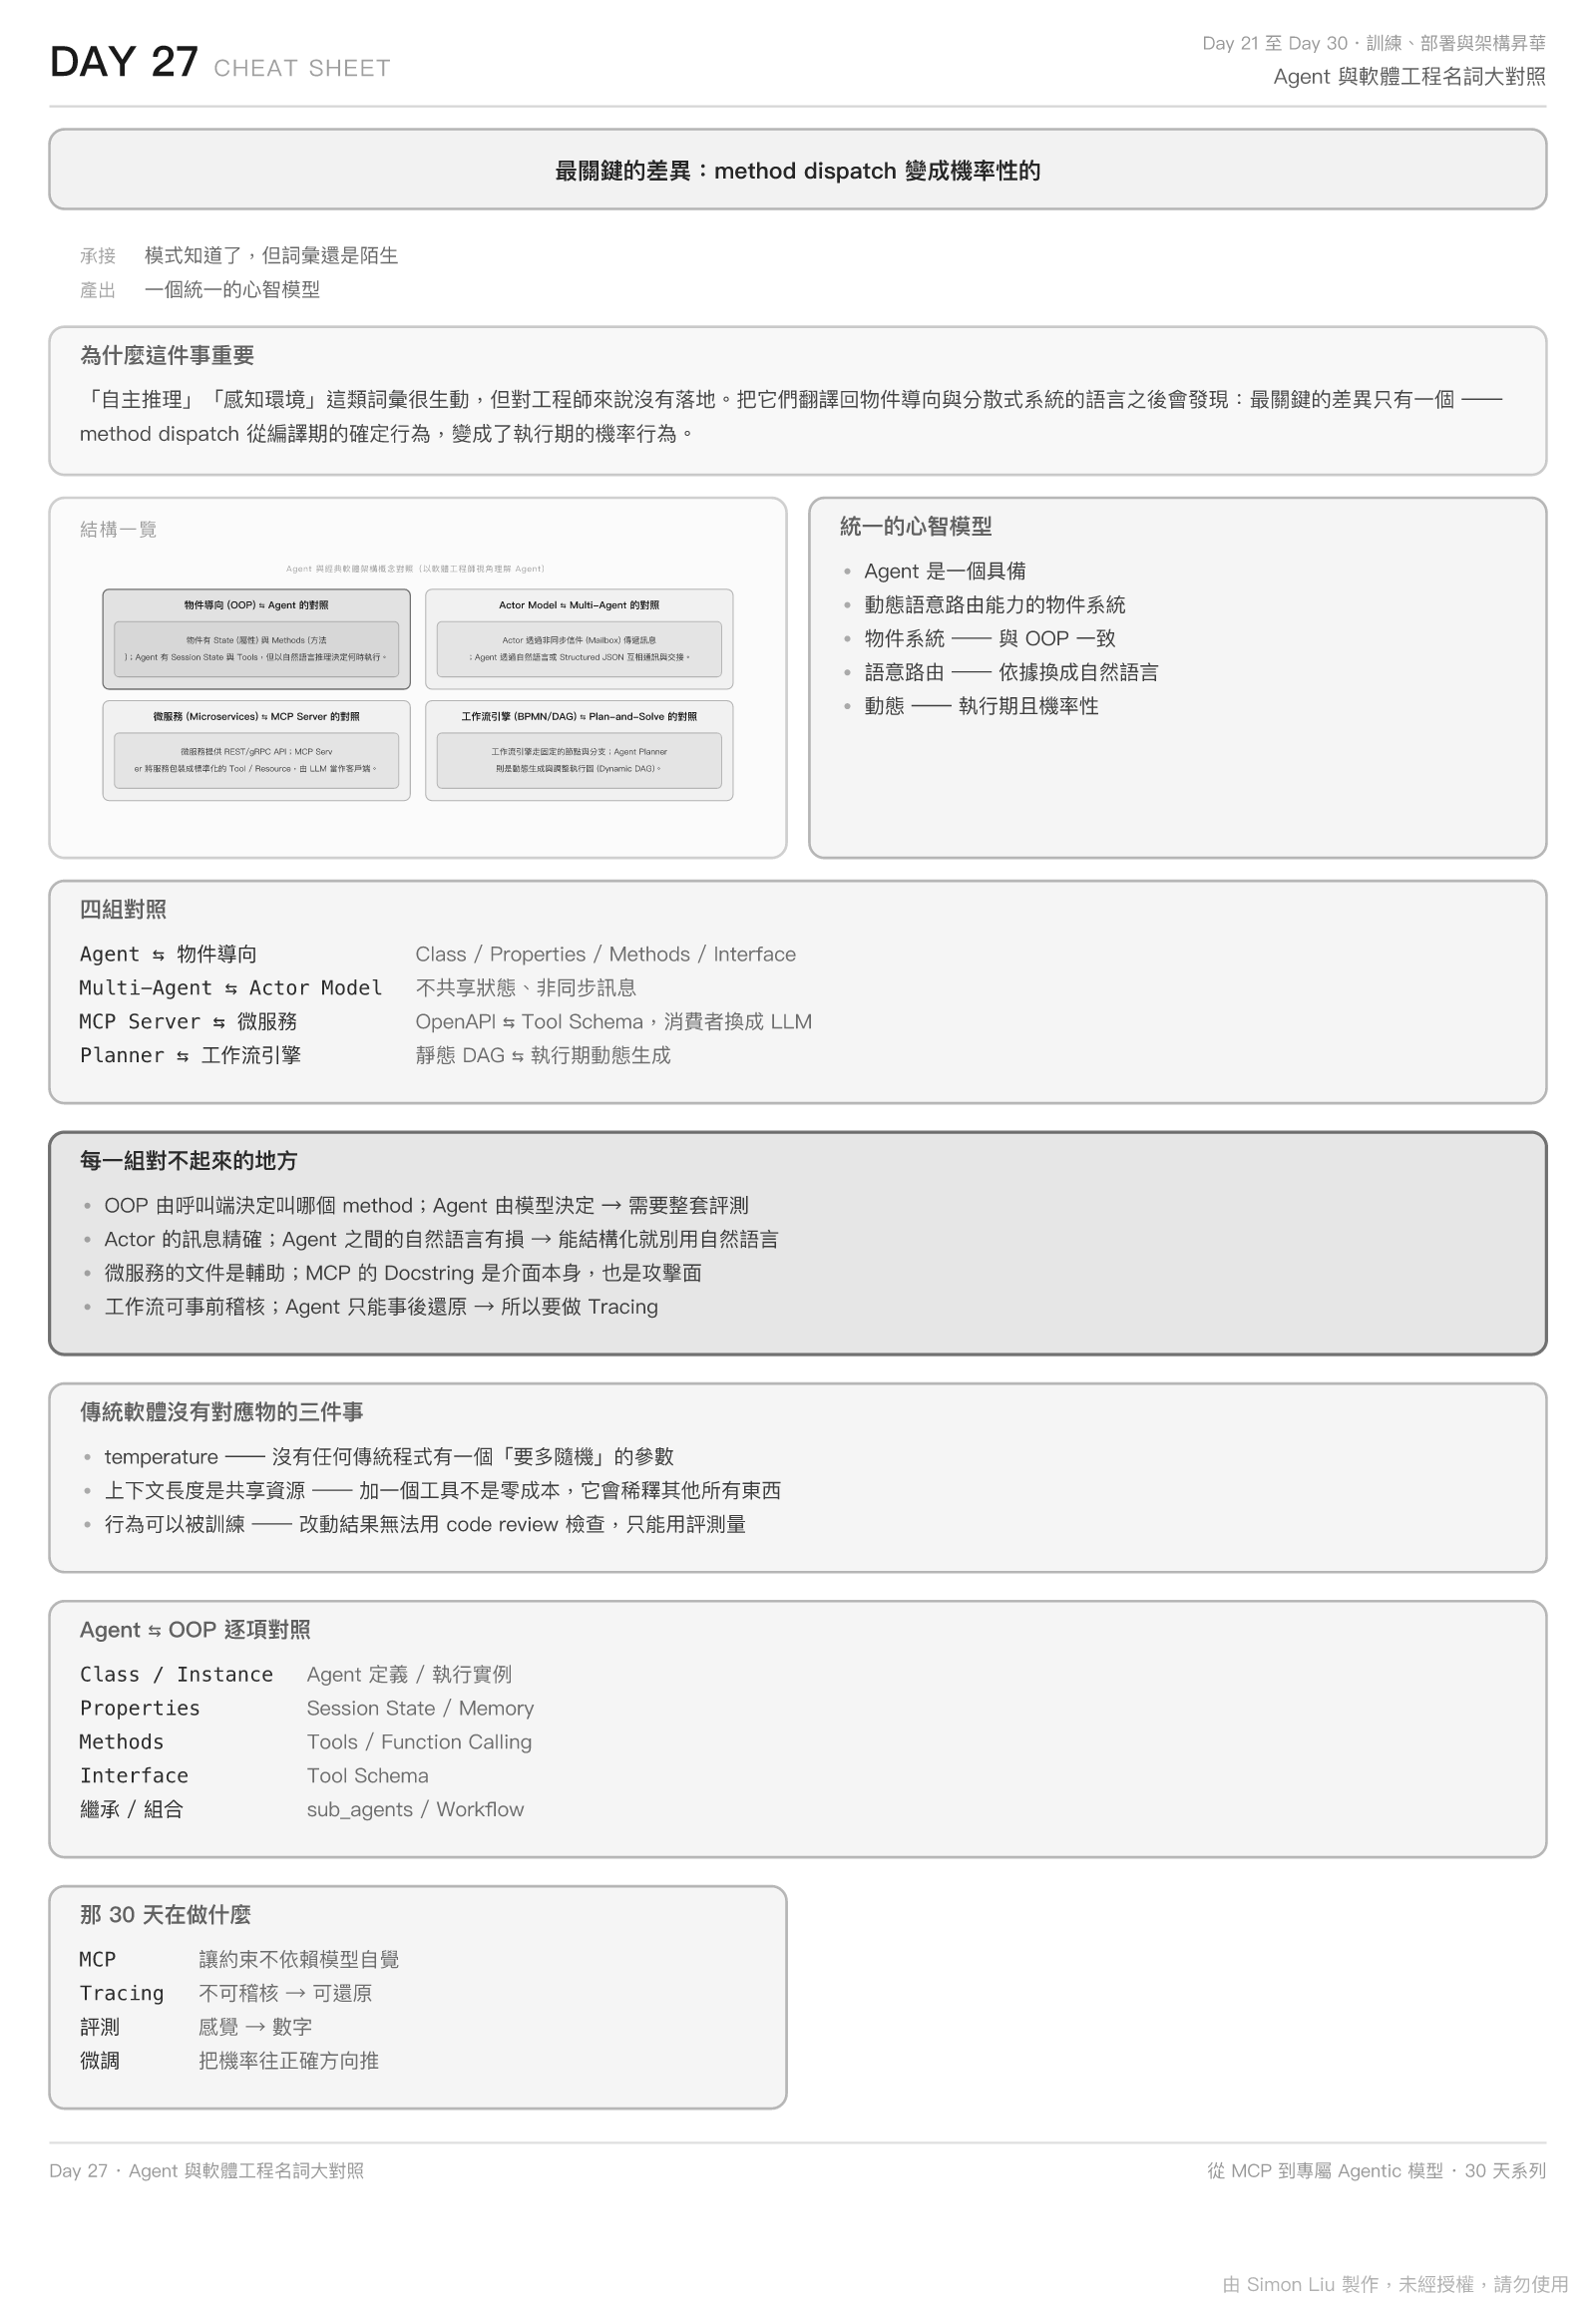
以下的內容,會逐一對照四組概念,最後收束到一個統一的心智模型。
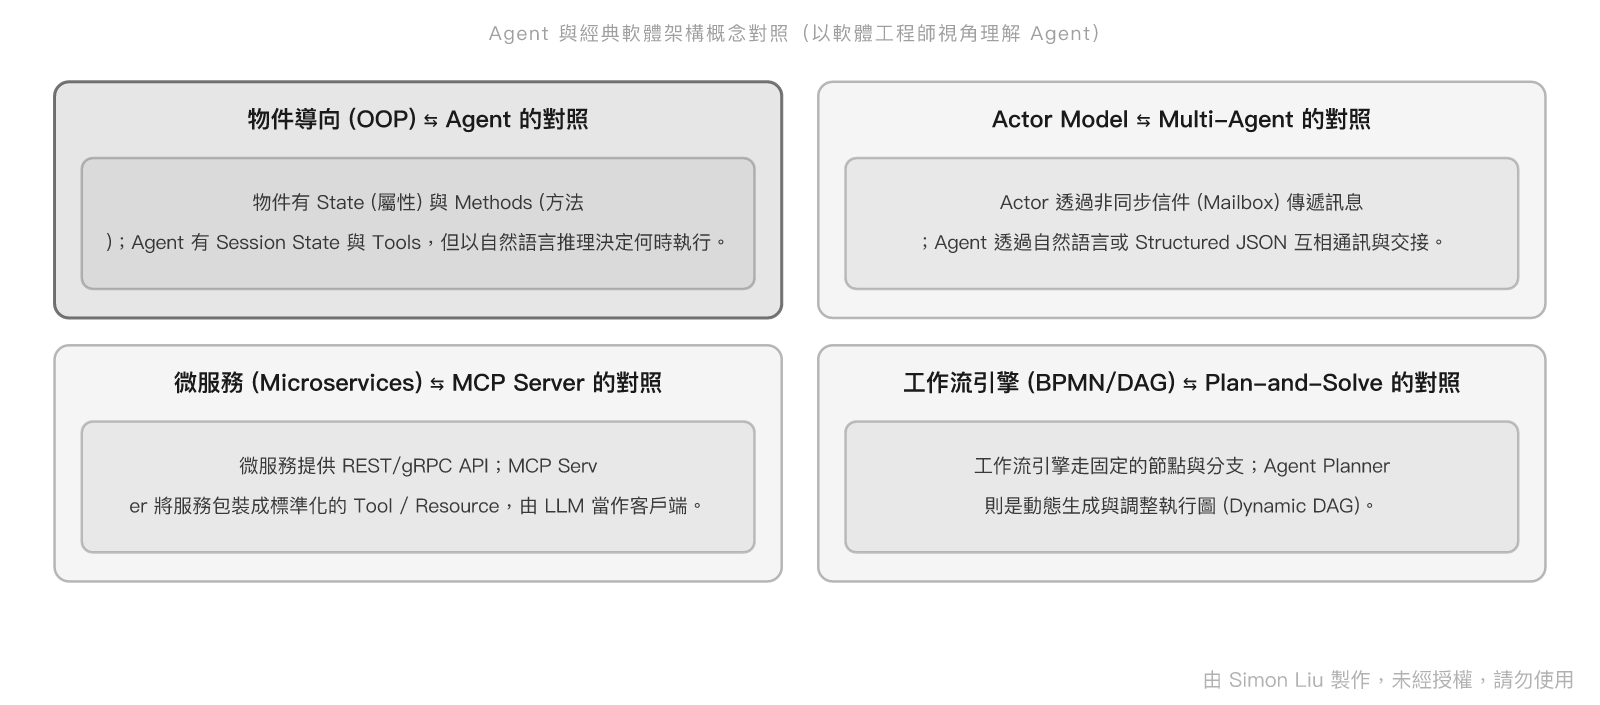
這是最直接的一組對照:
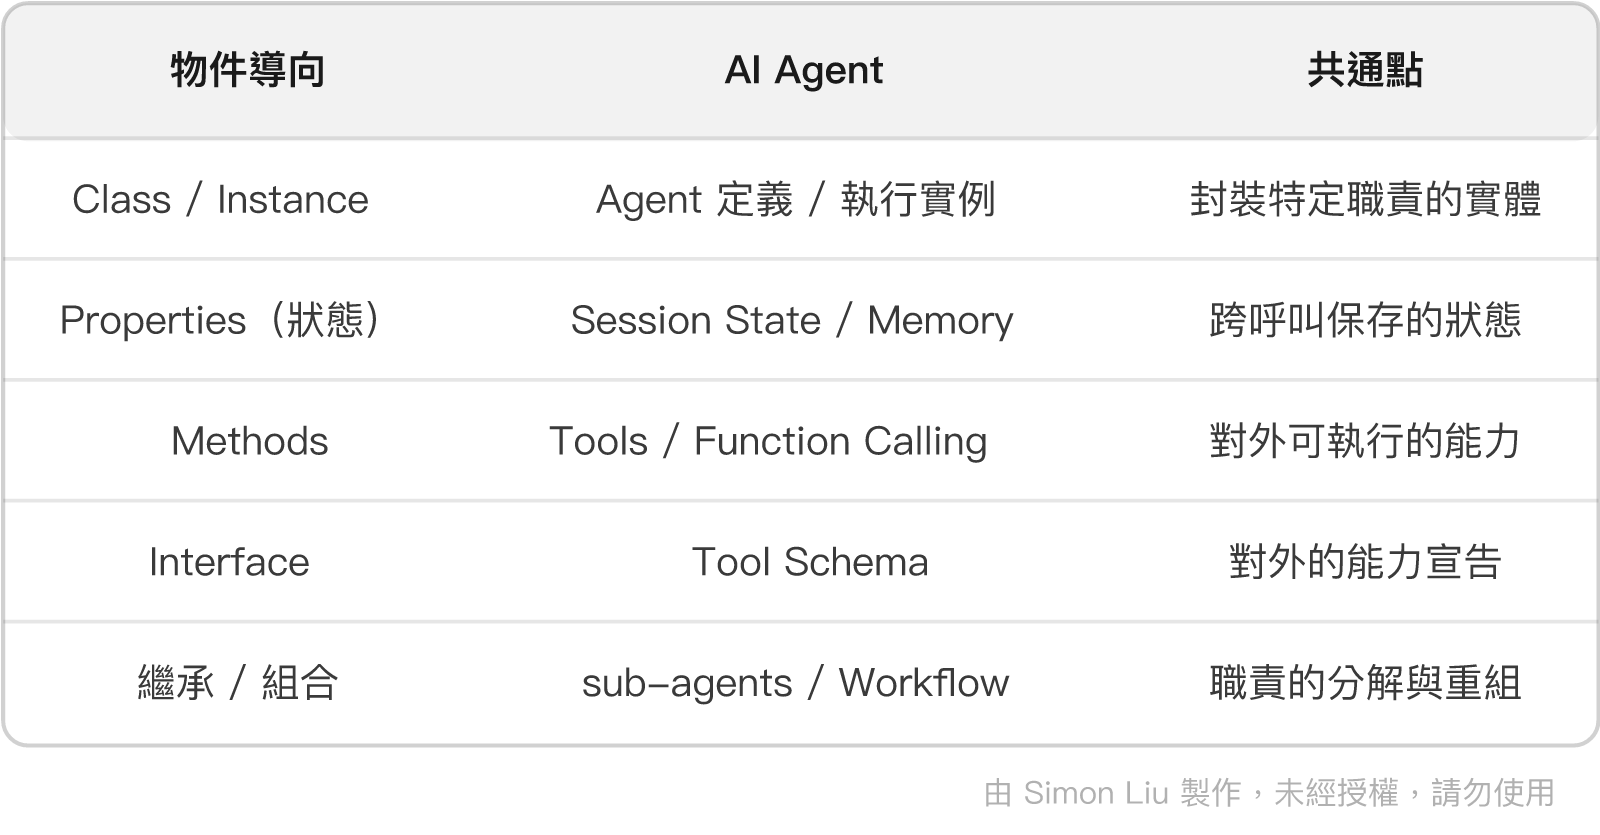
對不起來的地方,是最關鍵的那一點:
OOP 由呼叫端決定要叫哪個 method;Agent 由模型決定。
這一個差異衍生出後面所有的麻煩。在 OOP 裡,leave.update(status) 這行程式碼要嘛執行、要嘛編譯不過;在 Agent 裡,同樣的意圖有可能變成 update_leave_status、可能變成 search_leaves 之後才 update_leave_status、也可能變成一個參數填錯的 update_leave_status。
「method dispatch 變成機率性的」 —— 這就是為什麼需要 Day 12 至 Day 14 的整套評測體系。傳統軟體不需要「量測 method 有沒有被正確呼叫」,因為那是編譯器的工作。
Erlang 與 Akka 的 Actor Model 是分散式系統的基石,它的三條核心原則是:
Multi-Agent 系統在結構上高度吻合:各 Agent 擁有私有的記憶與工具,透過訊息(自然語言或結構化 JSON)協同。Day 10 的雙 Agent 架構就是一個最小的 Actor 系統。
對不起來的地方:Actor 的訊息是精確的,Agent 的訊息是有損的。
Actor Model 裡的訊息是型別明確的資料結構;Agent 之間傳的往往是自然語言,而自然語言的傳遞會失真。
Day 10 提過三類失敗,其中一類正是「查得對、但交接時資訊掉了」—— 這在 Actor Model 裡不會發生,因為訊息是原封不動送達的。
這也是為什麼 Day 10 選擇用
output_key把結果寫進 state,而不是讓 Agent 用自然語言互相轉述。能結構化的就不要用自然語言傳。
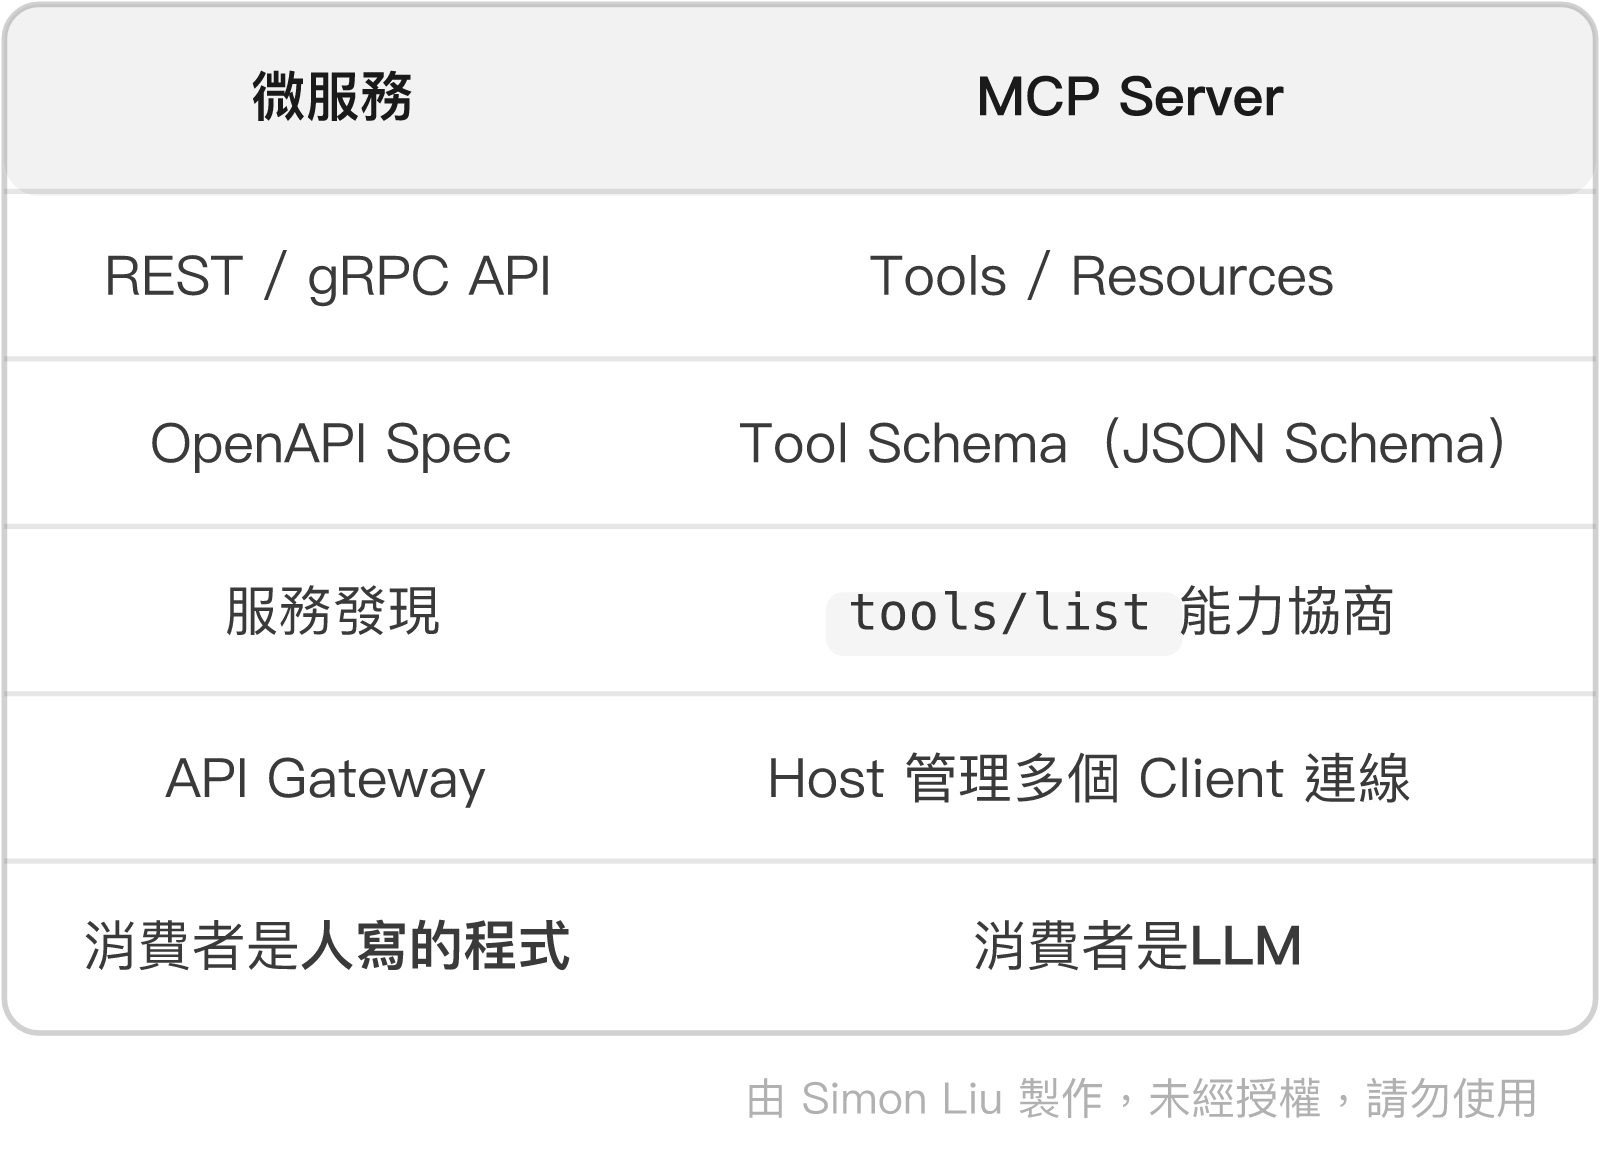
最後一列是整組對照的重點。MCP Server 本質上就是一個微服務,只是它的消費者換成了模型。
而這個轉換帶來一個具體的差異:文件從「輔助」變成了「介面的一部分」。
寫微服務時,API 文件寫得好不好,影響的是接手的工程師要花多久看懂。寫 MCP Server 時,Docstring 寫得好不好,直接決定模型會不會叫對 —— 因為那段文字會原封不動進入模型的上下文。
Day 3 說過「Docstring 不再只是給人看的註解,它是會實際進入模型上下文的 Prompt」,講的就是這件事。而 Day 4 的安全模型則是它的另一面:既然描述會進入上下文,那它就是一個攻擊面。
Airflow、Camunda 這類工作流引擎,依賴工程師在事前畫好一張靜態的 DAG。
Agent Planner 則是在執行期根據當下的觀察動態生成執行路徑 —— 可以理解成一張每一步都可能改變的 Dynamic DAG。
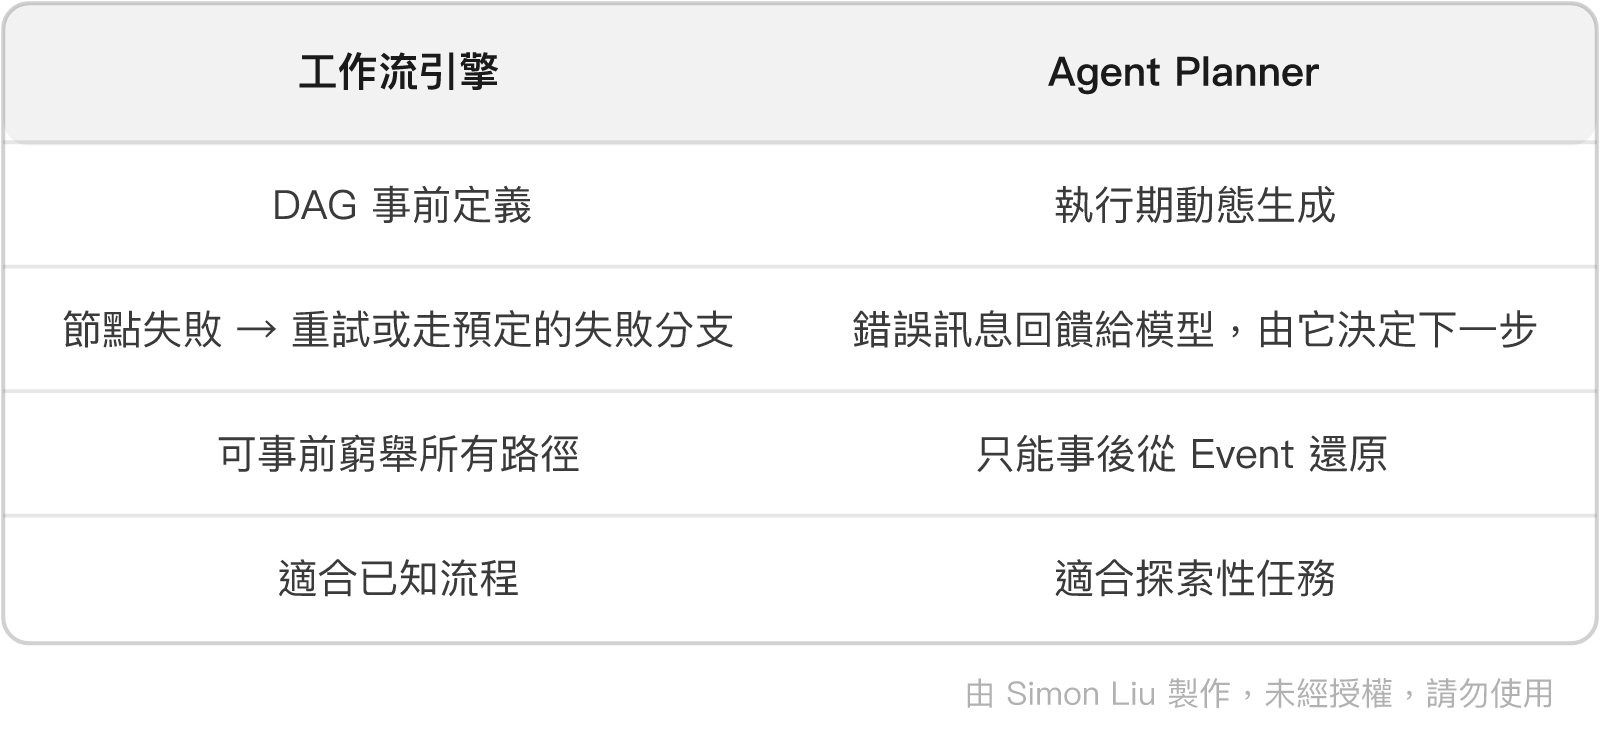
對不起來的地方:可稽核性。
工作流引擎的每一條路徑都能在上線前被檢視與核准,這在合規場景下是硬需求。Agent 做不到這一點 —— 它的路徑只能事後重建,而那正是 Day 11 花一整天處理 Tracing 的原因。
這一組對照也直接解釋了 Day 25 的結論:需要事前稽核的地方用 Flow,需要臨場判斷的地方用 Agent。
四組對照之外,有三件事在傳統軟體工程裡沒有對應物,值得單獨拿出來。
第一,temperature。
沒有任何傳統程式有一個「要多隨機」的參數。這是 LLM 系統獨有的,也是為什麼 Day 13 與 Day 23 都堅持 temperature=0 —— 評測時要先把這個變數關掉,否則量到的是雜訊。
第二,上下文長度是一種資源。
傳統程式的「參數」不佔用共享的預算,但 Agent 的每一個工具 schema、每一段 instruction、每一輪對話歷史,都在消耗同一個有限的上下文。
這使得「加一個工具」不是零成本的操作 —— 它會稀釋其他所有東西的相對權重。Day 10 的 tool_filter 與 Day 26 的 Router 都是在處理這個限制。
第三,行為可以被訓練,而不只是被撰寫。
這是整個系列最特別的一點。傳統軟體要改變行為,只能改程式碼;而 Agent 系統多了一條路徑 —— 改變模型的權重。
Day 15 至 Day 23 走的就是這條路。它的特殊之處在於:改動的結果無法用 code review 檢查,只能用評測量。 這也是為什麼 Day 13 那把尺必須先做出來、而且必須凍結。
把上面的對照收攏,可以得到一個相當實用的說法:
Agent 是一個具備動態語意路由能力的物件系統。
拆開來看:
而這 30 天做的所有事情,都是在處理「機率性」這三個字帶來的後果:
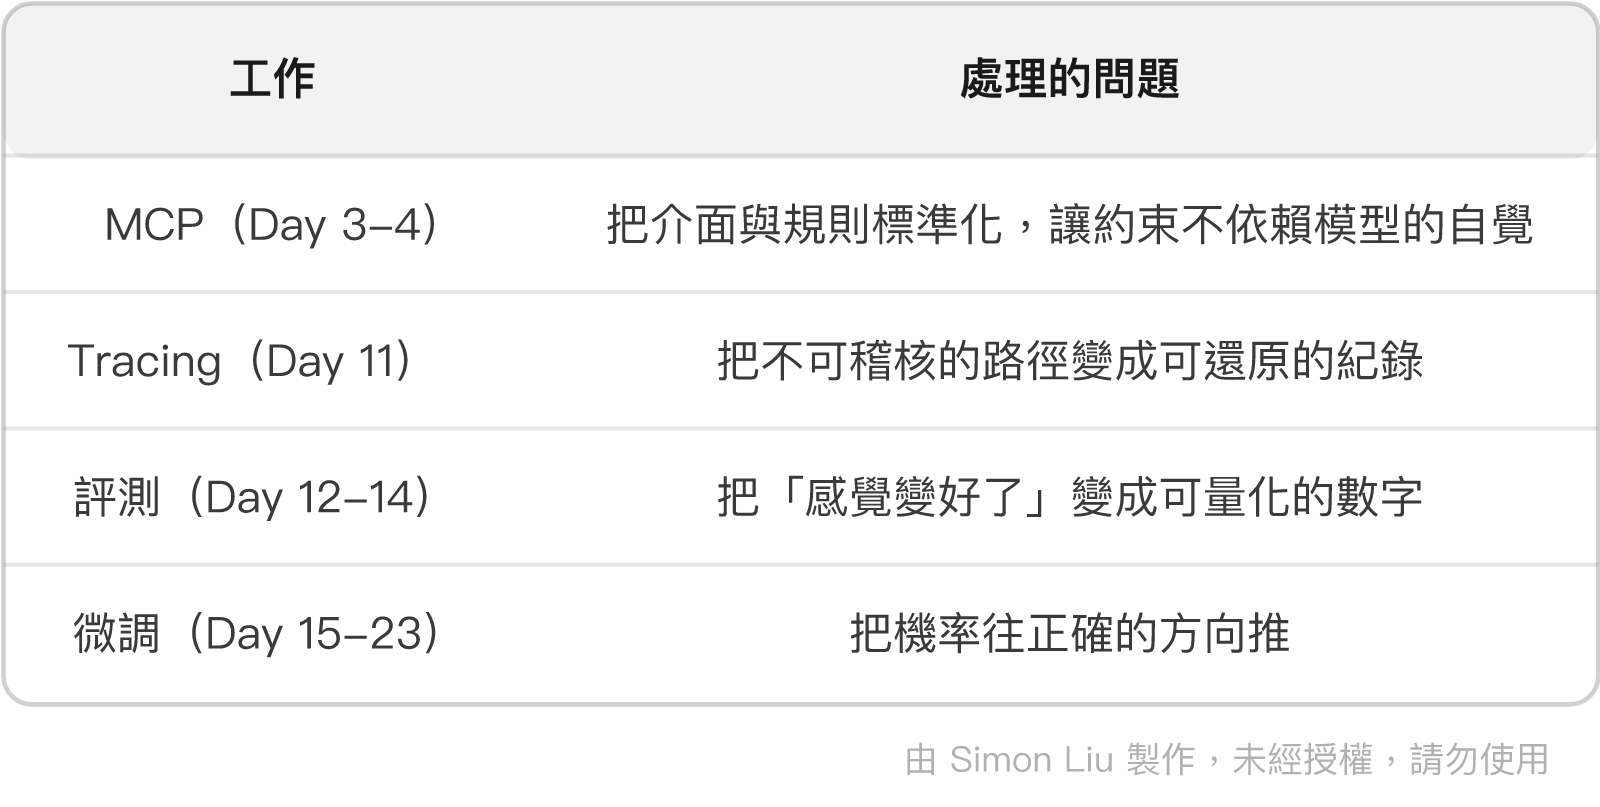
用工程師熟悉的話來說:我們在為一個 dispatch 不可靠的系統,補上型別檢查、日誌與測試。
擬人化的詞彙有它的溝通價值,但要做工程決策時,把它們翻譯回熟悉的概念會清楚得多。
總結來說,今天有三個重點值得帶走:
output_key 而不是讓 Agent 互相轉述,正是為了避開這個問題。tool_filter 與 Router 模式處理的都是這個限制。明天要把這套系統推向生產環境,處理最後一個問題:當一次誤刪就可能造成營運事故時,該怎麼建立縱深防禦?
tools/list、Host / Client / Server 架構sub_agents、output_key
google/adk/workflow/__init__.py(google-adk 2.7.1)——Workflow 的靜態圖描述查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術